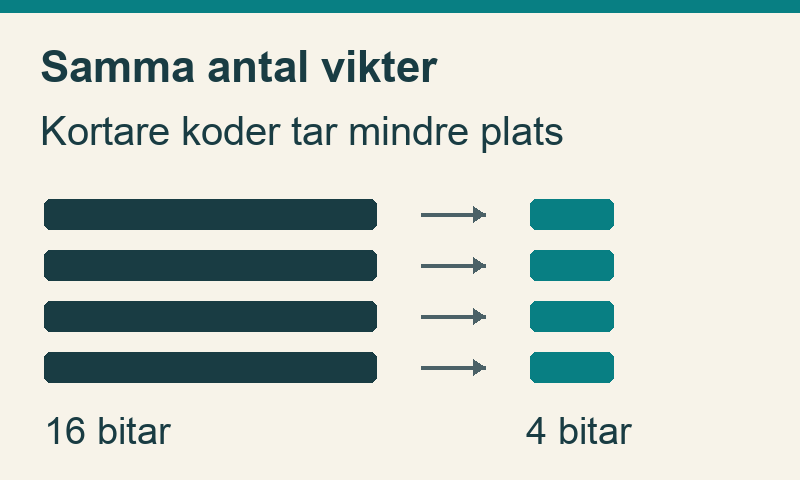
Modellen använder inlärda tal
En språkmodell använder tal när den räknar fram ett svar. Många av dessa tal har bestämts under träningen och kallas vikter. En vikt multipliceras med ett annat tal i beräkningen och påverkar därmed resultatet.[2]
Tänk dig att en vikt är 0,73. Vi ska följa den genom en förenklad beräkning. Talet är påhittat för att göra stegen lätta att se.
Här börjar vi med en färdigtränad modell. Vi ändrar hur dess vikter lagras. Den sortens ändring kan göras efter träningen och behålla samma antal vikter.[3]
Låt talet välja en grövre plats
Tänk dig en tallinje där de tillåtna platserna ligger 0,1 från varandra: 0,0, 0,1, 0,2 och så vidare till 1,5. Avståndet 0,1 är vår skala. Vikten 0,73 ligger närmast 0,7 och flyttas därför dit. Skillnaden blir 0,03.[4]
Utsnitt ur exemplets tallinje. Avrundningen flyttar 0,73 till 0,7.[4]
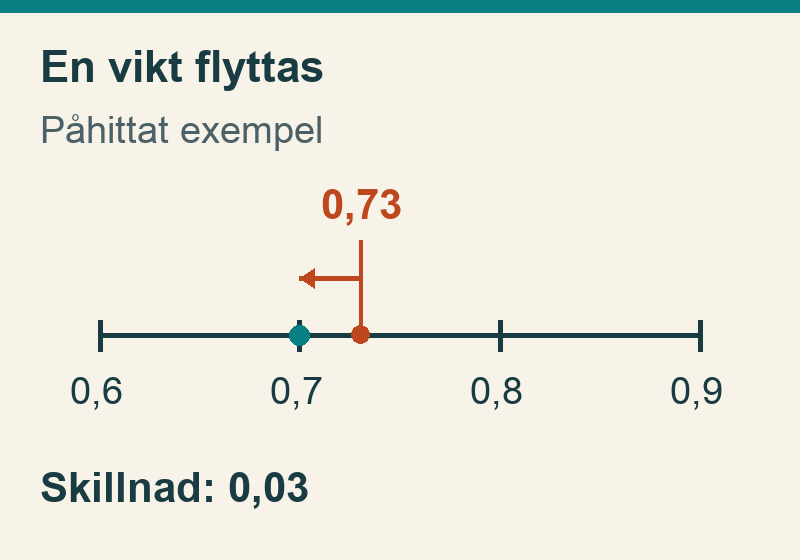
Vi kan lagra numret på den valda platsen, här 7, tillsammans med information om skalan. När talet ska användas får vi tillbaka 7 × 0,1 = 0,7. Det ursprungliga 0,73 går inte att återskapa exakt från de uppgifterna.[4]
Att byta till en mindre uppsättning tillåtna tal kallas kvantisering. Verkliga metoder väljer nivåer efter modellens tal. De kan också hantera negativa tal. Vår tallinje visar bara ett enkelt exempel på principen.[5]
Färre bitar för varje vikt
Datorn lagrar information som nollor och ettor. Varje sådan position kallas en bit. Med två bitar finns fyra kombinationer: 00, 01, 10 och 11. Med fyra bitar finns sexton kombinationer. Var och en kan få beteckna en av tallinjens sexton platser.[6]
Det är därför lagringen kan krympa: varje vikt får en kortare kod. Fyra bitar betyder alltså fyra nollor eller ettor i koden, inte fyra siffror efter decimaltecknet.[7]
Anta nu att en modell har en miljard vikter och att alla lagras med samma antal bitar. Åtta bitar är en byte, ett annat mått på datamängd. Med 16 bitar per vikt behövs två byte per vikt: sammanlagt två miljarder byte. Med 4 bitar per vikt kan två vikter packas i en byte. Då behövs en halv miljard byte.[8]
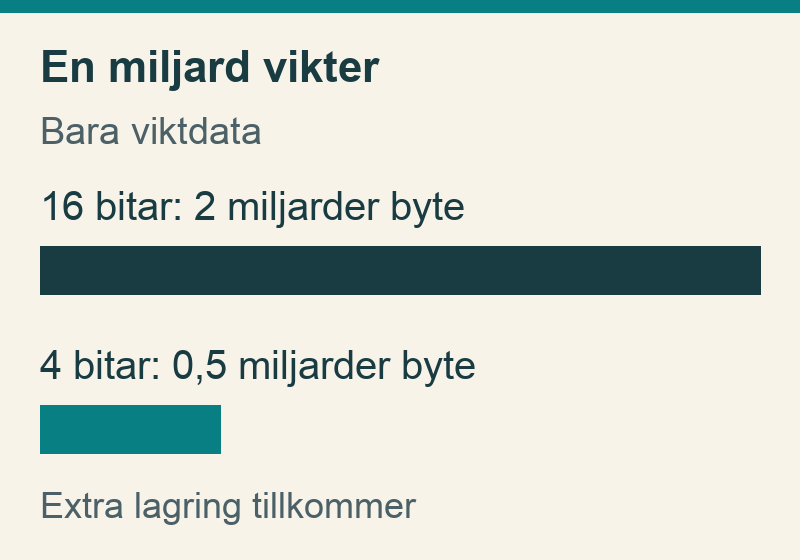
Bara viktdata räknas här. Den korta stapeln är en fjärdedel av den långa.[8]
Vi har fortfarande en miljard vikter. Besparingen kommer från hur varje vikt skrivs, medan antalet är oförändrat.[8]
När felet följer med
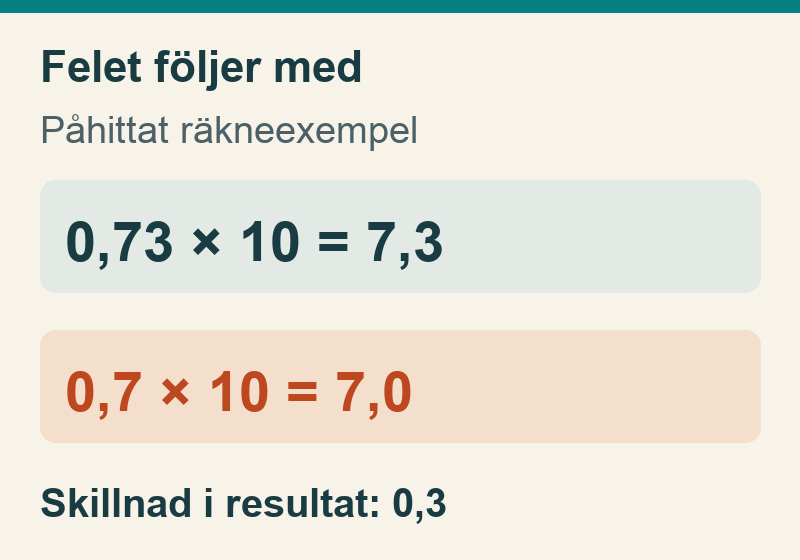
Låt vår påhittade vikt multipliceras med 10. Ursprungligen blir resultatet 0,73 × 10 = 7,3. Efter avrundningen blir det 0,7 × 10 = 7,0. Skillnaden i den här beräkningen är alltså 0,3.[9]
Påhittade tal visar ett räknefel. Bilden mäter inte kvaliteten på ett AI-svar.[9]
En språkmodell gör många beräkningar med vikterna. Ändrade resultat kan påverka den fortsatta texten. Hur väl modellen klarar en uppgift behöver därför prövas med den kvantiserade versionen. Ett fel på 0,03 i en vikt betyder inte att svaren blir tre procent sämre.[10]
Forskningsmetoden GPTQ försöker begränsa felet i beräkningarnas resultat. Den använder exempel som körs genom modellen. När vissa vikter avrundas justeras andra, ännu inte avrundade vikter för att kompensera. Det visar varför en metod kan behöva ta hänsyn till hur talen arbetar tillsammans.[11]
Filen och arbetsminnet
En verklig modellfil behöver också uppgifter som gör viktkoderna begripliga. Skalorna är ett exempel. De kan delas av grupper av vikter, men tar ändå plats. Därför anger vårt räkneexempel bara utrymmet för själva viktkoderna.[12]
När modellen körs behöver den dessutom plats för tillfälliga beräkningar och för programmet som utför arbetet. Filstorleken räcker därför inte för att ange hela behovet av arbetsminne.[13]
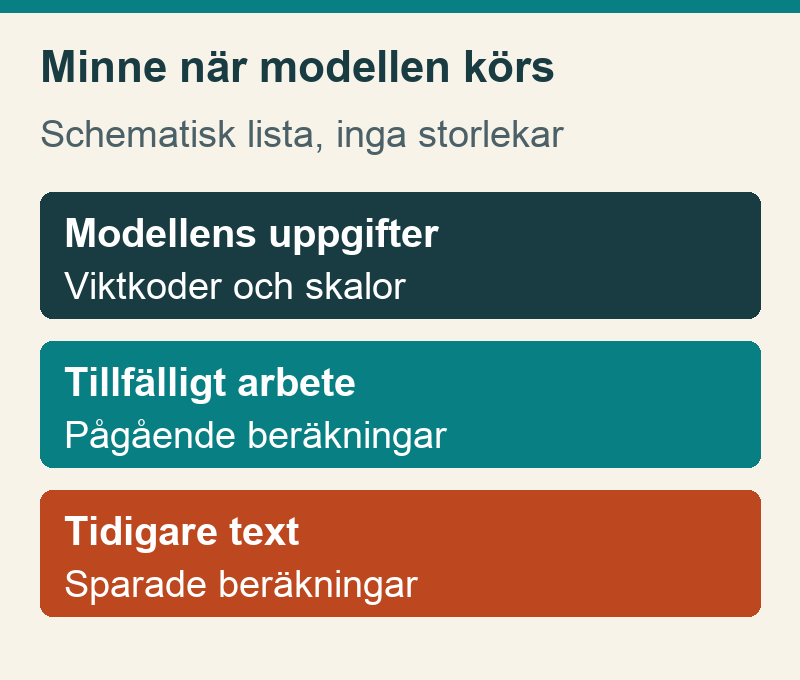
Vid textgenerering kan modellen också spara beräknade uppgifter om tidigare text, så att de kan återanvändas i nästa steg. Detta mellanlager kallas KV-cache. Det tar minne utöver vikterna.[14]
Olika saker behöver plats när modellen körs. Rutorna visar inga uppmätta storlekar.[13][14]
Mindre att flytta – men hur snabbt?
Mindre viktdata kan minska tiden för att flytta talen från minnet till delarna som räknar. Samtidigt kan koder behöva packas upp och räknas om. Den sammanlagda hastigheten beror på både datorns delar och programmet som använder dem. En fjärdedel så mycket viktdata ger därför inget löfte om fyra gånger snabbare svar.[15]
För att bedöma en viss variant föreslår vi fyra separata frågor: Hur stor är filen? Hur mycket minne används när den arbetar? Hur lång tid tar svaret? Och klarar den de uppgifter du behöver? Då får platsbesparingen en konkret betydelse i just din användning.