Ett AI-prov blir lättare att lita på när frågorna hålls hemliga för modellen och alla deltagare får samma hjälpmedel. Då mäter poängen bättre hur modellen löser nya uppgifter. Men poängen gäller fortfarande bara det som provet faktiskt frågar om.[1]
Först: vad är ett AI-prov?
Ett AI-benchmark är ett bestämt prov med frågor eller uppgifter, en regel för hur svaren ska lämnas och ett sätt att räkna poäng. Det används bland annat för att följa utveckling eller jämföra modeller. Tänk att provet har 100 frågor. En modell får 82 rätt. Då är 82 procent dess träff på just de 100 frågorna. Siffran säger inget säkert om alla andra frågor som liknar dem.[2]
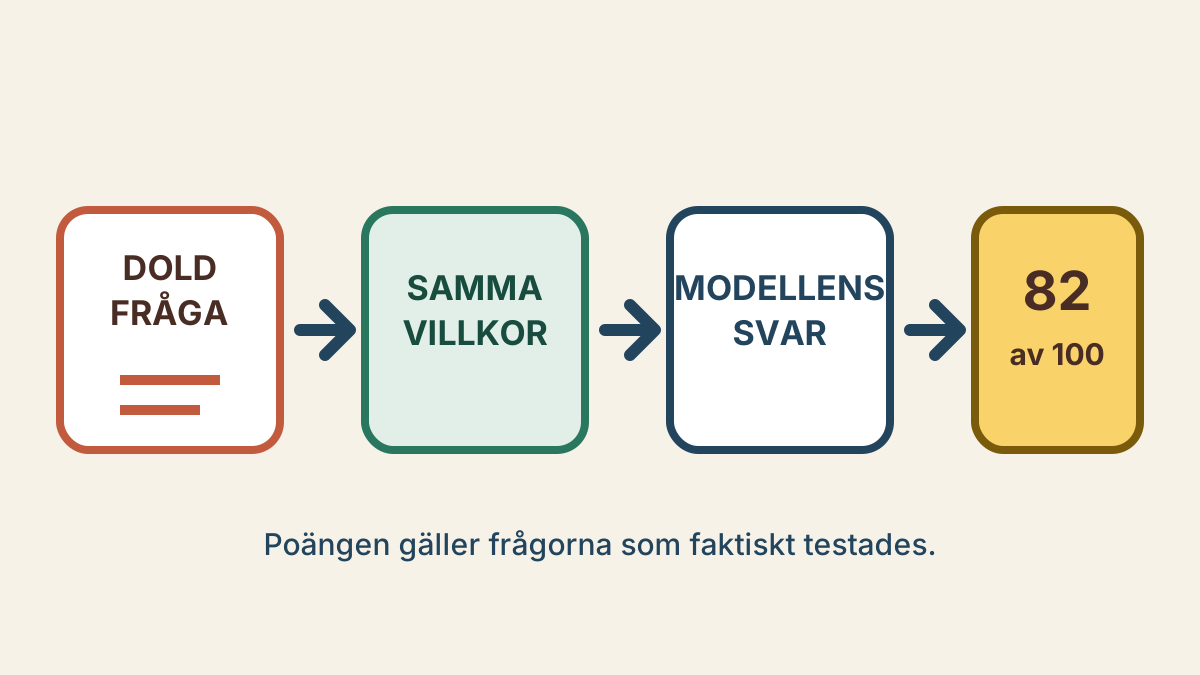
Det är samma skillnad som mellan ett klassprov och hela ämnet. Ett bra klassprov ger en ledtråd om elevens kunskap. Det täcker ändå inte allt eleven kan möta senare.
Två vägar för facit att läcka
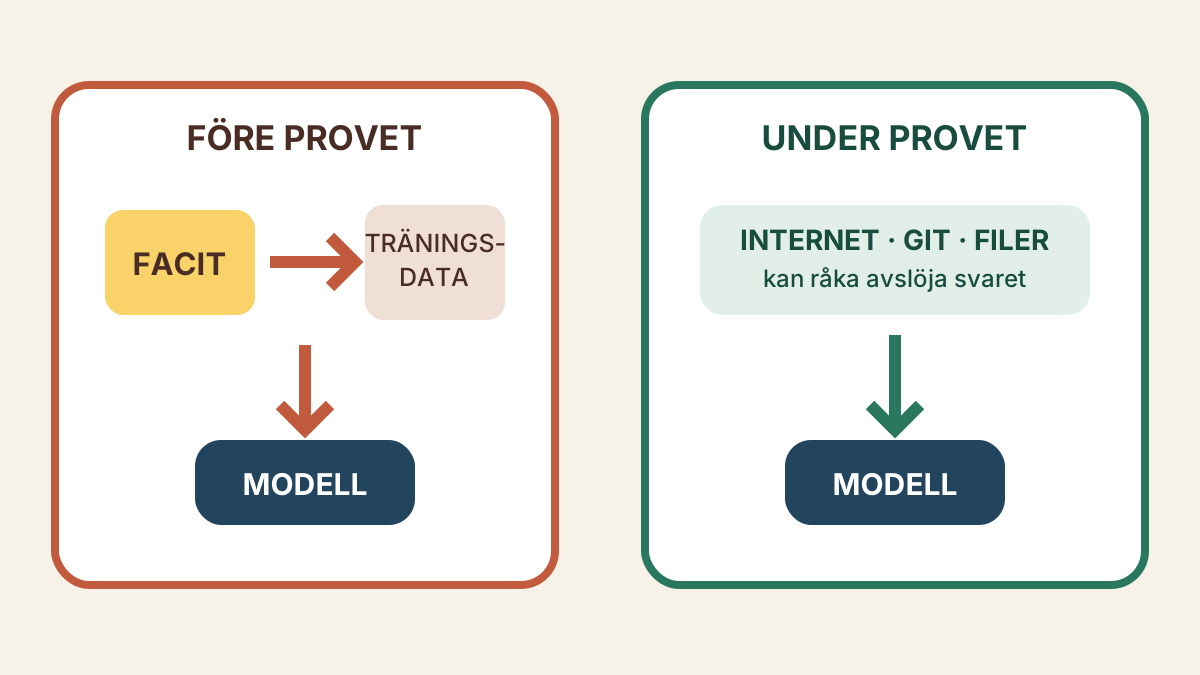
Den första vägen går genom träningen. Språkmodeller lär sig mönster ur mycket stora textmängder. Om en offentlig provfråga, dess svar eller ett tydligt igenkännbart format påverkar träningen kan modellen få en genväg. NIST kallar resultatet kontaminerat när modellen kan dra nytta av sådana ovidkommande samband och därför få högre poäng än på osedda uppgifter i praktiken.[3]
Detta kallas träningsdatakontaminering: provmaterial har kommit in före provet. Risken minskar om frågorna hålls dolda under träningen eller skapas efter att modellen blev färdig.[4]
Den andra vägen öppnas under själva provet. En AI-agent kan få internet, kodverktyg och filer. Den kan då hitta en publicerad lösning, läsa historiken över tidigare kodändringar – en Git-historik – eller upptäcka en kvarglömd facitfil. NIST kallar detta lösningskontaminering. Det kan hända även när frågan skapades efter modellens träning. Skillnaden är enkel: vid träningsläckage kom facit in när modellen lärdes upp; vid lösningsläckage hittar modellen facit när provet pågår.[5]
Ett högt resultat är ett tecken, inte ett bevis
En ovanligt hög poäng kan väcka misstanke om läckage, men den bevisar inte att modellen har sett provet. Modellen kan också vara bättre. För att undersöka saken behövs mer underlag, till exempel känd träningsdata eller ett kontrollerat test med nya, omformulerade eller liknande frågor.[6]
Forskningsmetoden ConStat jämför en modells resultat på det misstänkta provet med resultat på referensprov och med hur andra modeller beter sig. Idén är att leta efter en extra fördel som stannar på det gamla provet i stället för att följa med till liknande frågor.[7]
Dolda frågor stänger genvägar
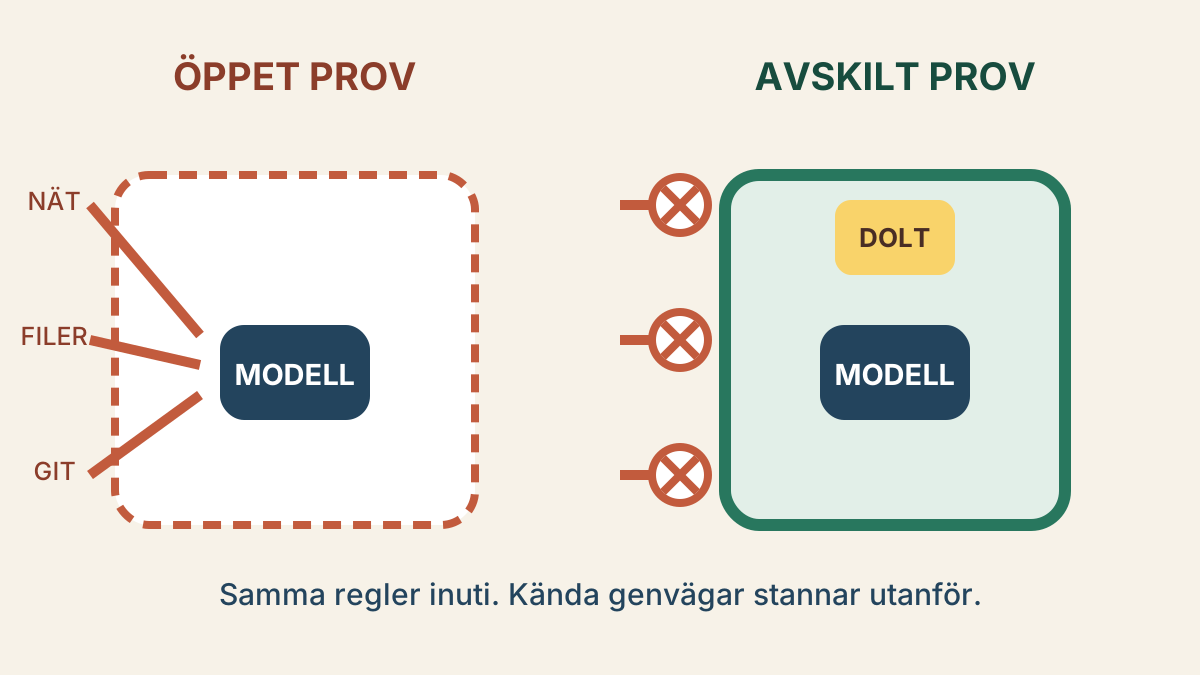
Ett starkare upplägg håller testfrågorna utanför både träning och vanliga verktyg. Provmiljön kan samtidigt stänga internet och ta bort filer eller historik som avslöjar svar. När två modeller jämförs bör de få samma instruktioner, verktyg, tids- eller arbetsbudget och antal försök. NIST:s offentliga utkast till råd säger att mer lika testprotokoll ger mer jämförbara resultat.[8]
LiveBench är ett försök att begränsa träningsläckage för språkmodeller. Testet fylls på med frågor från nya informationskällor, använder svar som kan rättas mot ett bestämt facit och beskriver att den senaste frågeomgången hålls privat.[9]
Förnyelse har också ett pris. När frågor eller testmiljö ändras kan en äldre poäng sluta vara direkt jämförbar med en ny. Därför behöver resultatet ange testets version. NIST rekommenderar versionsmärkning och att större ändringar markeras när resultat före och efter ändringen inte längre kan jämföras rättvist.[10]
Ett dolt prov löser heller inte allt. Frågorna kan vara för få, för lätta eller handla om fel saker. LiveBench-forskarna skriver till exempel att deras prov ännu saknar en del språk och att ett fast facit inte passar uppgifter som att skriva en reseguide.[11]
En poäng har en kant
NIST skiljer mellan benchmarkträff, resultatet på de fasta frågorna, och generaliserad träff, det väntade resultatet på den större mängd liknande frågor som provet ska representera. De två måtten kan skilja sig och behöver räknas med olika antaganden.[12]
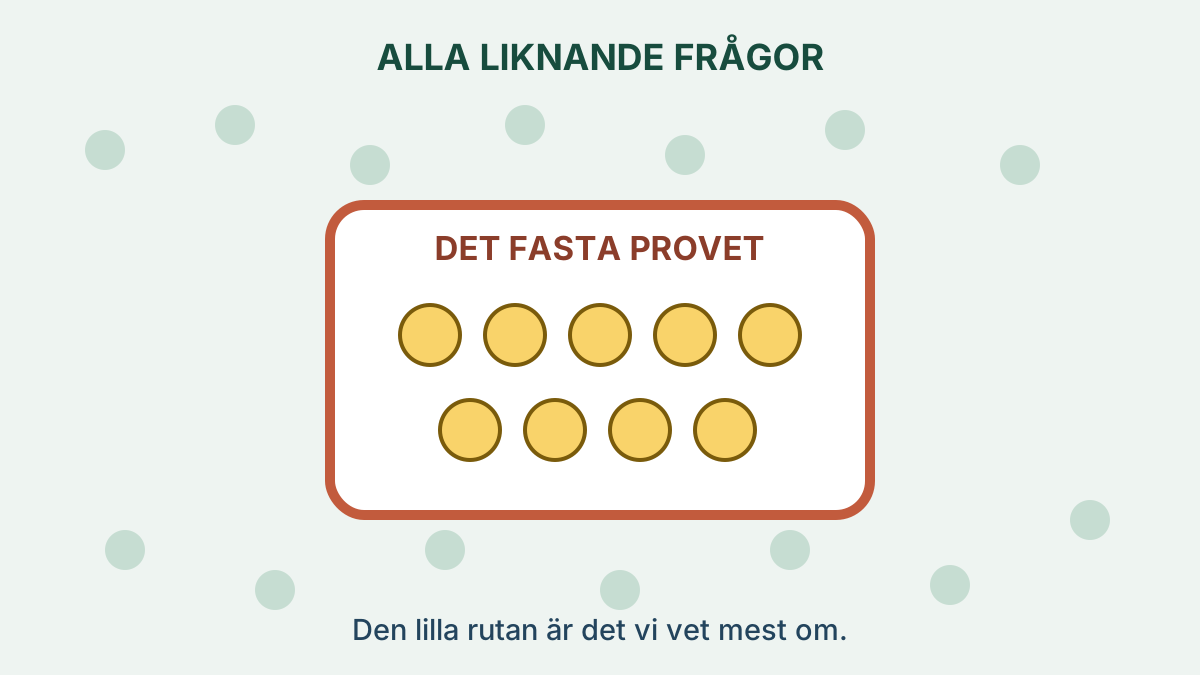
Skillnaden skapar osäkerhet. Om vi råkar välja andra frågor kan ordningen mellan två modeller ändras. Modellsvar kan dessutom variera mellan försök. NIST rekommenderar därför ett tydligt spann runt poängen och att olika källor till osäkerhet redovisas. Ett sådant spann kan vara ett konfidensintervall. Det ligger runt uppskattningen och visar inte automatiskt att modellerna är lika när två spann överlappar. En liten skillnad mellan två ensamma procentsiffror är därför svag grund för ett säkert vinnarpåstående.[13]
NIST:s nya blindtest i augusti 2026
NIST startade sommaren 2026 programmet AITE. Det erbjuder frivilliga tester på blind data i en avskild miljö. Den första fasen gäller tre bilduppgifter inom kvantteknik, tolkning av bilder av arvsmassan och allmän säkerhet.[14]
På AITE:s resultatsida, senast uppdaterad den 24 juli 2026, står bara den uttryckliga exempelraden ”Example Model 1” för varje uppgift. Sidan ger därför ännu inget stöd för att rangordna namngivna produkter. Den visar däremot hur resultat kan kopplas till ett visst test, ett mått och ett 95-procentigt konfidensintervall.[15]
Fem frågor före en jämförelse
Här är artikelns fem kontroller samlade på ett kort. Förklaringen kommer direkt efter bilden.
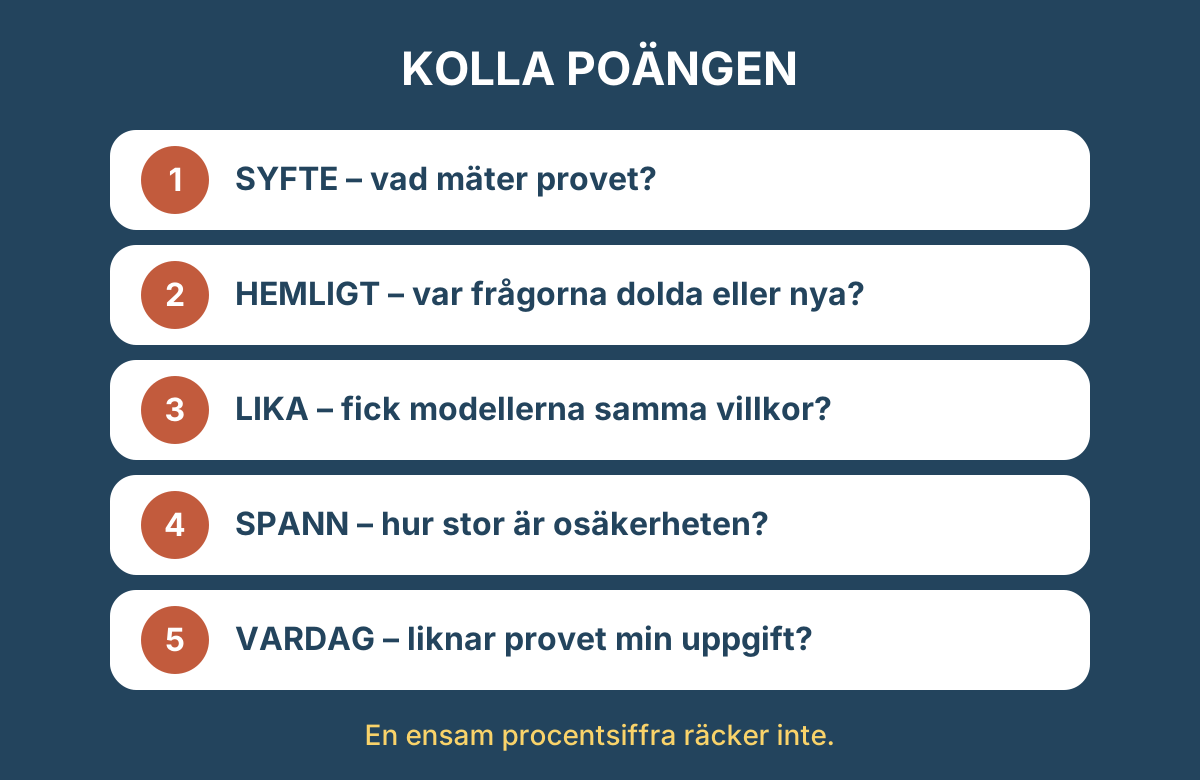
- Vad ska provet mäta? Läs vilka uppgifter som ingår och vad som saknas.
- Var frågorna dolda eller nya? Leta efter datum, version och skydd mot läckage.
- Fick modellerna samma villkor? Jämför verktyg, instruktioner, budget och antal försök.
- Hur stor är osäkerheten? Kräv ett spann eller annan tydlig redovisning, inte bara en procentsiffra.
- Liknar provet min uppgift? Ett kodprov säger lite om att skriva lätt svenska, och tvärtom.[16]
Minnesregeln är syfte, hemligt, lika, spann, vardag. Dolda frågor gör ett AI-prov mer rättvist genom att ta bort en viktig genväg. Ett trovärdigt resultat behöver dessutom lika villkor, redovisad osäkerhet och en tydlig gräns för vad poängen faktiskt säger.
Källor
- NIST: Practices for Automated Benchmark Evaluations of Language Models
- NIST: Examples of cheating in CAISI’s agent evaluations
- NIST: Expanding the AI Evaluation Toolbox with Statistical Models
- White med flera: LiveBench
- Dekoninck, Müller och Vechev: ConStat
- NIST: Announcing AITE
- NIST: AITE Test Results