Testet som gör glömskan synlig
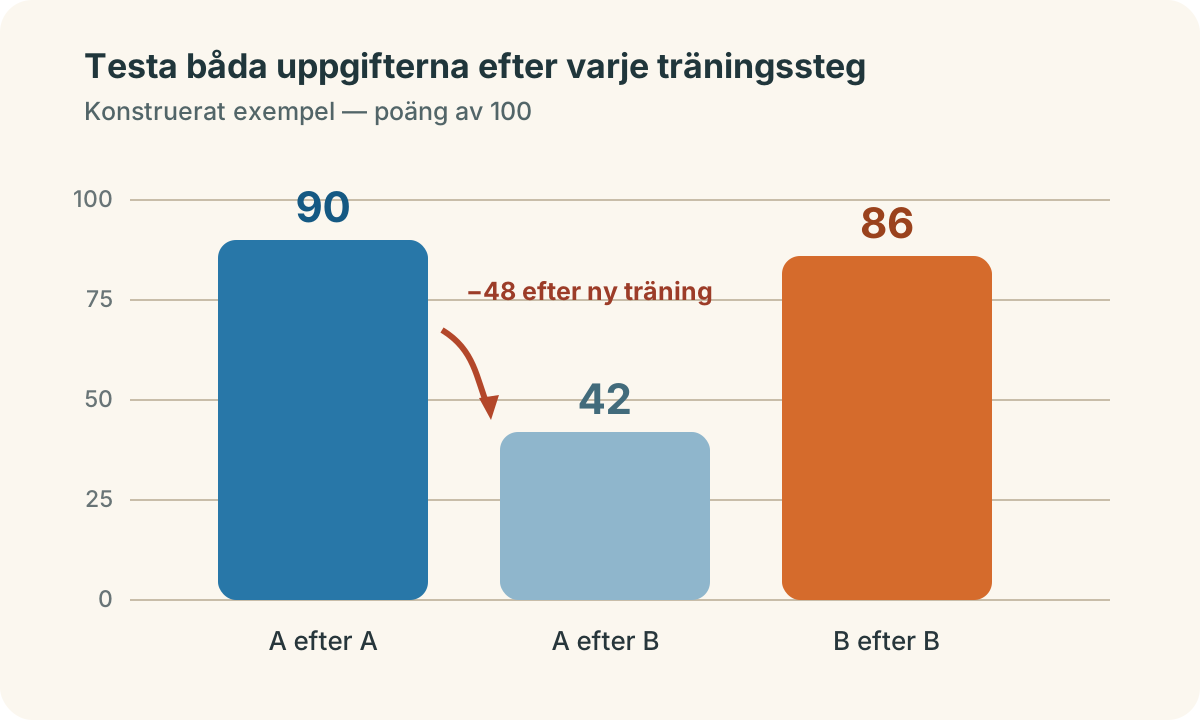
Föreställ dig ett litet neuralt nätverk som först lär sig uppgift A: att skilja handskrivna ettor från tvåor. När modellen klarar ett separat test på A tränas samma nätverk på uppgift B: att skilja treor från fyror. Samma viktuppdateringar som förbättrar B kan då försämra A.[1] Katastrofal glömska visar sig om resultatet på det sparade A-testet sedan faller kraftigt, trots att A-testet och dess facit är oförändrade.[2]
Ett enkelt före-och-efter-test behöver därför tre mätpunkter: A efter träning på A, B efter träning på B och A ännu en gång efter B. Forskning om kontinuerligt lärande sammanfattar ofta glömska som skillnaden mellan en uppgifts bästa tidigare resultat och resultatet efter senare träning.[3]
Ett konstruerat räkneexempel: A går från 90 till 42 av 100 efter B-träningen, medan B når 86. Siffrorna är valda för att visa mätningen och kommer inte från ett experiment.
Vad som ändras när B tar över
Ett neuralt nätverks färdighet finns fördelad över många vikter – tal som styr hur starkt signaler påverkar varandra. Samma vikt kan bidra till flera uppgifter. När träning på B flyttar en sådan delad vikt kan beräkningen som tidigare gav rätt svar för A samtidigt förändras.[4]
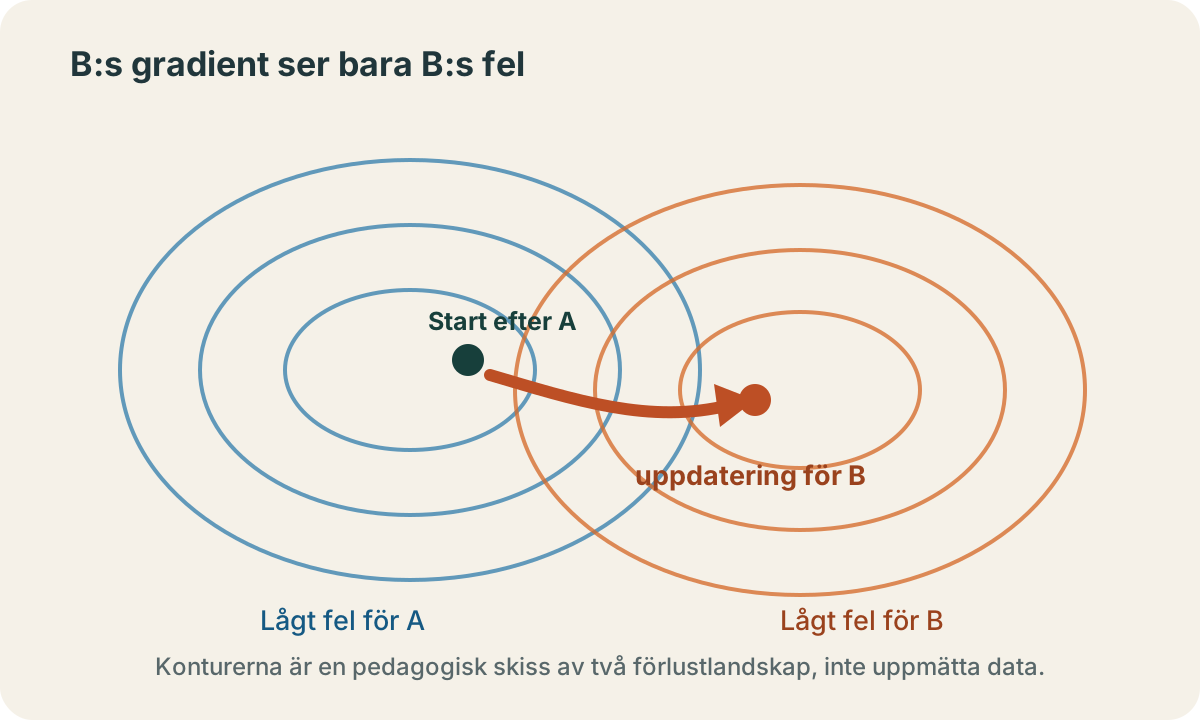
Under vanlig gradientbaserad träning beräknas först hur väl modellen klarar den aktuella träningsomgången. Gradienten anger sedan åt vilket håll vikterna bör flyttas för att minska felet. Om träningsomgången bara innehåller B får uppdateringen ingen direkt signal om att A ska bevaras.[5]
Pilen följer B:s träningssignal. Den passerar samtidigt från ett område där A fungerar väl till ett område där A fungerar sämre.
Tänk på vikterna som reglagen på ett ljusbord för två teaterscener. Scen A kräver ett visst förhållande mellan blått, gult och vitt ljus. När teknikern ställer om samma reglage för scen B kan A:s ljusbild förstöras. Liknelsen hjälper oss se den delade resursen, men den slutar där: ett neuralt nätverk har ofta miljontals eller miljarder samverkande parametrar, och en ”färdighet” går sällan att koppla till ett enda reglage.
Kapacitetsbrist förklarar därför inte hela fenomenet. Nätverk som tappar äldre uppgifter vid sekventiell träning kan i vissa försök lära samma uppgifter när exemplen blandas under gemensam träning.[6] Hur mycket A påverkas beror bland annat på vilka parametrar uppgifterna delar, hur deras träningssignaler samverkar och i vilken ordning data kommer; när signalerna pekar åt liknande håll kan ny träning också hjälpa en äldre uppgift.[7]
Balansen mellan att bevara och förändra
Stabilitet–plasticitet är namnet på avvägningen. Stabilitet betyder att äldre kunskap står emot störande uppdateringar. Plasticitet betyder att modellen fortfarande kan ändras tillräckligt mycket för att lära den nya uppgiften. Kontinuerligt lärande försöker kombinera båda under begränsningar i minne, beräkning och tillgång till äldre data.[8]
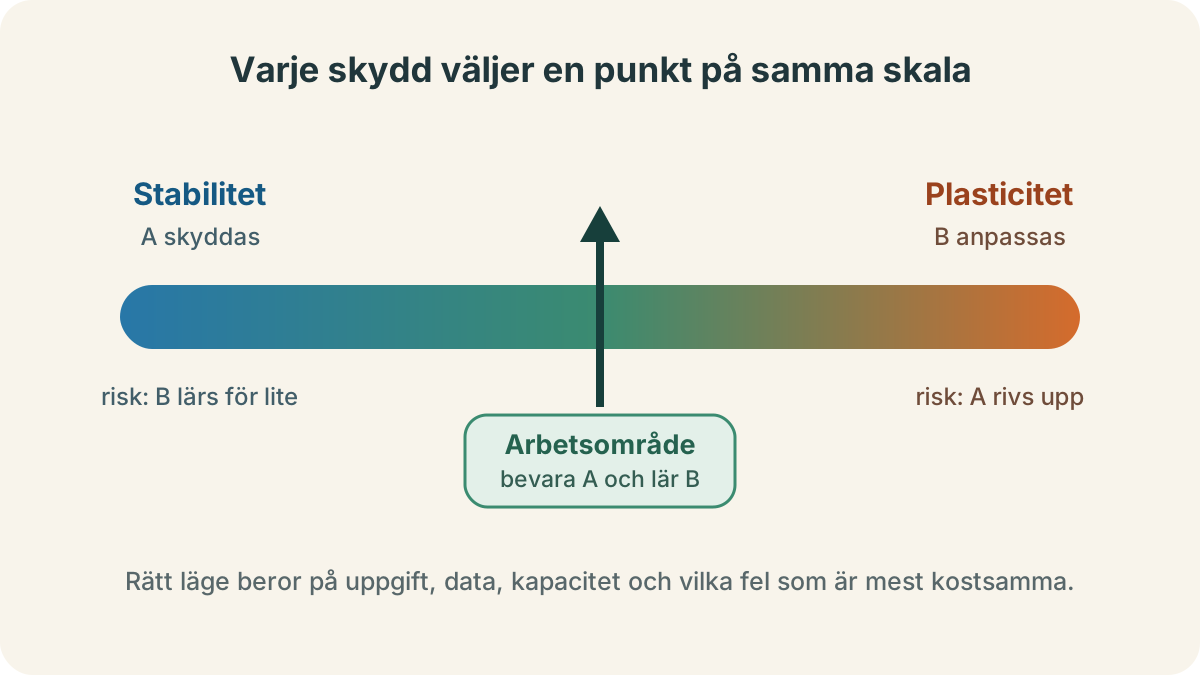
För långt åt vänster fastnar modellen i det gamla. För långt åt höger kan nya uppdateringar riva upp det gamla. Det användbara området beror på uppgifterna och kraven.
En helt låst modell bevarar A men lär sig inte B. En helt obunden modell kan snabbt anpassa sig till B men riskerar A. Motåtgärderna skiljer sig främst i vad de ger modellen som påminnelse eller skydd när B tränas.
Tre sätt att skydda en äldre färdighet
De vanligaste lösningarna kan ordnas i tre familjer: återinför äldre erfarenhet, bromsa ändringar av viktiga vikter eller ge uppgifterna mer åtskilda delar av modellen.[9]
Tre familjer angriper samma konflikt på olika ställen: i träningsdata, i uppdateringsregeln eller i modellens struktur.
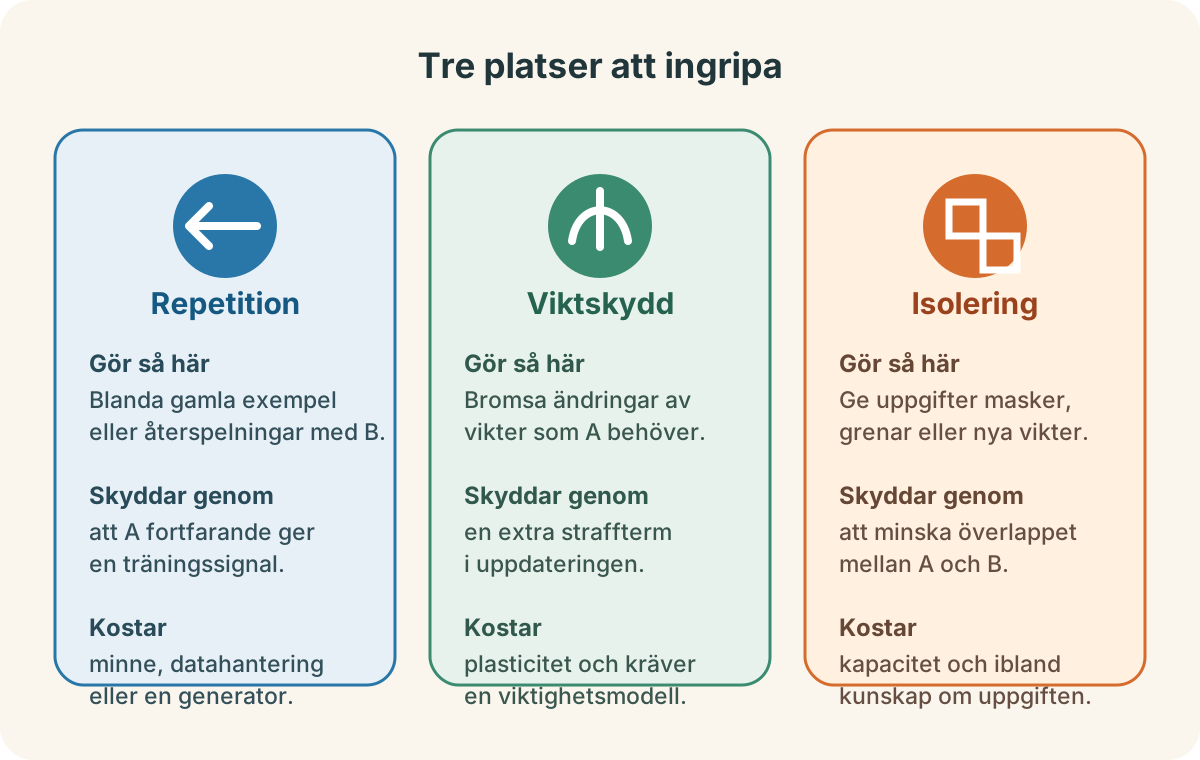
1. Repetition låter A höras under B
Med experience replay, erfarenhetsrepetition, blandas ett urval äldre exempel med de nya. Uppdateringen får då signaler från både A och B. En variant lagrar riktiga exempel i en minnesbuffert; en annan tränar en generator som skapar återspelade exempel eller interna representationer.[10]
Repetition är ofta stark i benchmarktester, men den flyttar problemet till urval och lagring. Riktiga exempel kräver minne och kan omfattas av integritets- eller rättighetskrav. Genererade exempel slipper en del lagring men generatorn kan själv glömma eller ge för dåliga återspelningar, och studier visar att resultatet beror kraftigt på uppgiftens svårighet och testscenario.[11]
2. Viktskydd bromsar de känsligaste ändringarna
Elastic Weight Consolidation, EWC, uppskattar vilka vikter som var viktiga för A och lägger till en straffterm när B-träningen försöker flytta just dem långt. Mindre viktiga vikter kan ändras friare. Metoden bygger alltså en mjuk skyddszon, inte ett absolut lås.[12]
Uppskattningen av viktighet är i sig en modellförenkling. En analys av EWC, Synaptic Intelligence och Memory Aware Synapses visar att metoderna har närmare matematisk släktskap än deras olika motiveringar först antyder.[13] Skyddet kan minska glömskan i en uppställning och ändå misslyckas i en annan, särskilt när modellen måste skilja alla gamla och nya klasser utan att få veta vilken deluppgift ett exempel tillhör.[14]
3. Parameterisolering minskar kollisionerna
En arkitekturbaserad metod kan ge varje uppgift en mask, en egen gren eller nya parametrar. Hard Attention to the Task lär exempelvis en mask som styr vilka delar av nätverket en uppgift får använda; andra metoder låter strukturen växa när nya uppgifter anländer.[15]
Åtskillnaden minskar direkta kollisioner men har ett pris. Fler uppgifter kan förbruka mer modellkapacitet, och vissa lösningar behöver veta uppgiftsidentiteten även vid testning för att välja rätt mask eller gren.[16] I ett öppet system där uppgiften inte är märkt blir själva vägvalet ännu ett problem som måste utvärderas.
Ett resultat gäller bara sitt test
Benchmarkens upplägg påverkar slutsatsen. I ett uppgiftsinkrementellt test får modellen ofta veta vilken uppgift som gäller och väljer mellan ett begränsat antal svar. I ett klassinkrementellt test måste den däremot skilja mellan alla klasser den sett hittills. Samma metod kan se stark ut i det första scenariot och tappa kraftigt i det andra.[17]
En rättvis jämförelse redovisar därför minst fyra saker: resultatet på gamla uppgifter, resultatet på den nya, extra minne och extra beräkning. Den bör också ange om äldre data sparades, om uppgiftsidentiteten gavs vid testning och hur många uppgifter och träningsordningar som prövades. Aktuell forskning fortsätter att föreslå nya avvägningar, vilket är ett tecken på att ingen ensam metodfamilj har löst alla varianter av problemet.[18]
För konstruktören blir före-och-efter-matrisen viktigare än ett enda slutbetyg. Ett skydd kan se bra ut genom att frysa nästan allt och därmed bevara A, samtidigt som B lärs dåligt. Ett annat kan ge högt medelvärde men dölja att just en kritisk gammal färdighet kollapsat.
Gränsen mot språkmodeller och chattminne
Stora språkmodeller kan också förlora tidigare förmåga när deras vikter fortsätter att tränas på nya domäner, tidsperioder eller uppgifter. Forskningsfältet skiljer bland annat mellan fortsatt förträning, domänanpassning och fortlöpande finjustering, med skilda risker och utvärderingar.[19]
En kort samtalskontext, en missad träff i extern informationshämtning eller ett enstaka felaktigt svar visar däremot inte i sig katastrofal glömska. Fenomenet i den här artikeln kräver en ändring av modellens tränade parametrar och en systematiskt mätt försämring av en äldre förmåga efter den ändringen.[20]
Resultat från små bildklassificerare kan visa mekanismen tydligt, men de kan inte utan vidare förutsäga hur en viss stor språkmodell reagerar på fortsatt träning. Modellstorlek, träningsdata, optimering, uppgiftsdefinition och testprotokoll förändrar problemet. Den säkra överföringen är därför testmetoden: mät den gamla förmågan före och efter, mät den nya förmågan, och redovisa vilket skydd samt vilka resurser som användes.
Källor
- Kirkpatrick med flera: Overcoming catastrophic forgetting in neural networks
- van de Ven, Siegelmann och Tolias: Brain-inspired replay for continual learning with artificial neural networks
- Wang med flera: A Comprehensive Survey of Continual Learning
- Benzing: Unifying Importance Based Regularisation Methods for Continual Learning
- Wu med flera: Mitigating Catastrophic Forgetting in Online Continual Learning
- Serra med flera: Overcoming Catastrophic Forgetting with Hard Attention to the Task
- Li med flera: Learn to Grow
- Shi med flera: Continual Learning of Large Language Models