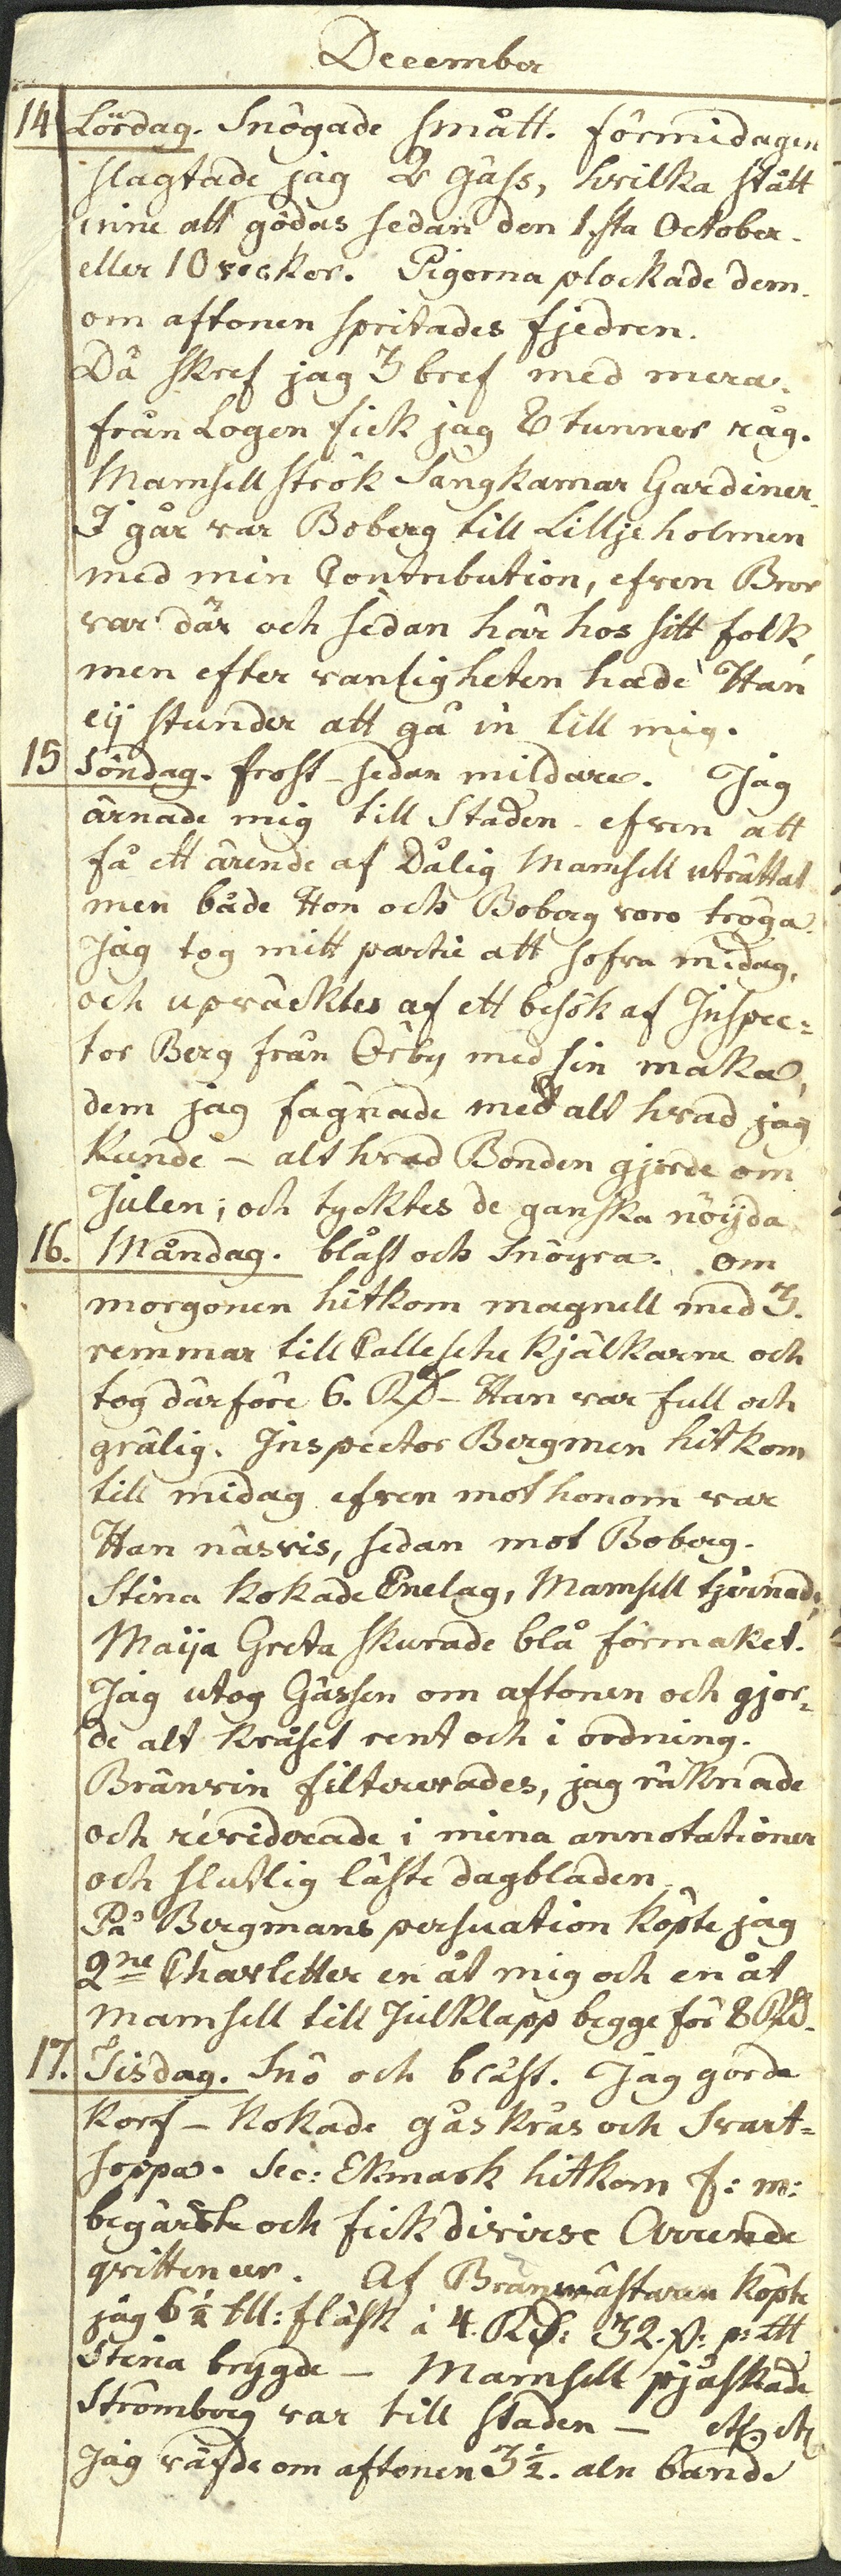
En sida blir två lager
Föreställ dig ett flyttningsbevis från 1700-talet. Bläcket har dragits över papperet med en hand som aldrig anade att en maskin skulle försöka läsa den. I Riksarkivets öppna exempel för verktyget HTRflow går ett sådant dokument genom hela kedjan. I den maskinella texten går det bland annat att urskilja namnet Sven Svensson Hjerpe och datum från 1773. [2]
För datorn är den skannade sidan först bara en bild: ljusa och mörka bildpunkter. Bilden går att visa på en skärm, men orden i den går inte automatiskt att söka. HTR, Handwritten Text Recognition, lägger därför till ett andra lager – maskinläsbar text – utan att ersätta originalbilden. Textlagret kan innehålla fel, så originalbilden måste finnas kvar för kontroll. [1]
Det finns en viktig gräns redan här. Riksarkivet kan bara AI-tolka material som har skannats, och myndigheten varnar för att luckor kan finnas även i arkiv som har bearbetats. [3] En söktjänst visar alltså inte hela historien; den visar den del av historien som först har blivit bild och därefter text.
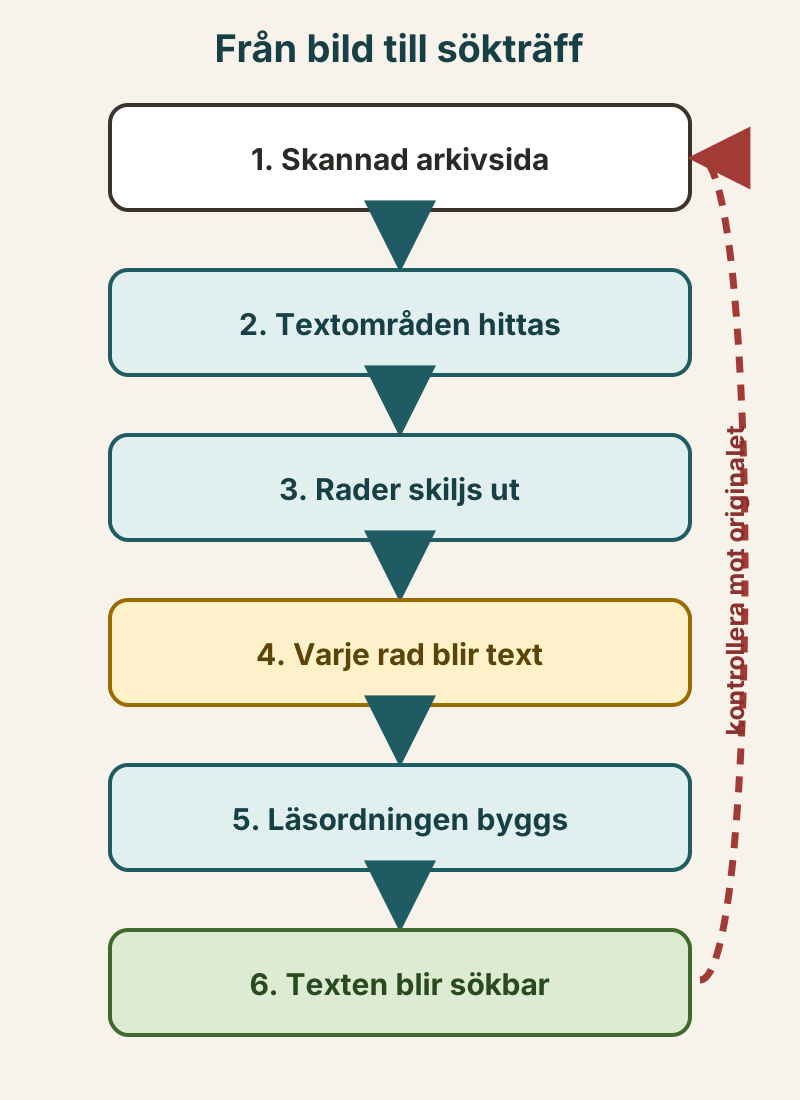
Kedjan består av separata steg: bild, segmentering, textigenkänning, läsordning, export och sökindex. [4]
Att stegen är separata är mer än en teknisk detalj. Det gör det möjligt att fråga var ett fel uppstod. Hittade systemet fel rad? Läste modellen ett tecken fel? Hamnade raderna i fel ordning? Eller fungerar texten men inte sökningen? Ett enda magiskt ”AI läser sidan” skulle dölja de frågorna.
1. Först måste systemet hitta raderna
En hel arkivsida är för stor och för rörig för en modell som ska tolka en rad i taget. Därför börjar HTRflow med segmentering: systemet hittar textområden och skiljer ut enskilda rader som egna bildbitar. [5]
Det här är närmare att skära ut remsor ur en kopia än att förstå språket. En rad kan vara sned, gå nära marginalen eller ligga tätt intill nästa. Segmenteringen ska peka ut var texten finns; själva textigenkänningen ska därefter föreslå vilka tecken som står där.
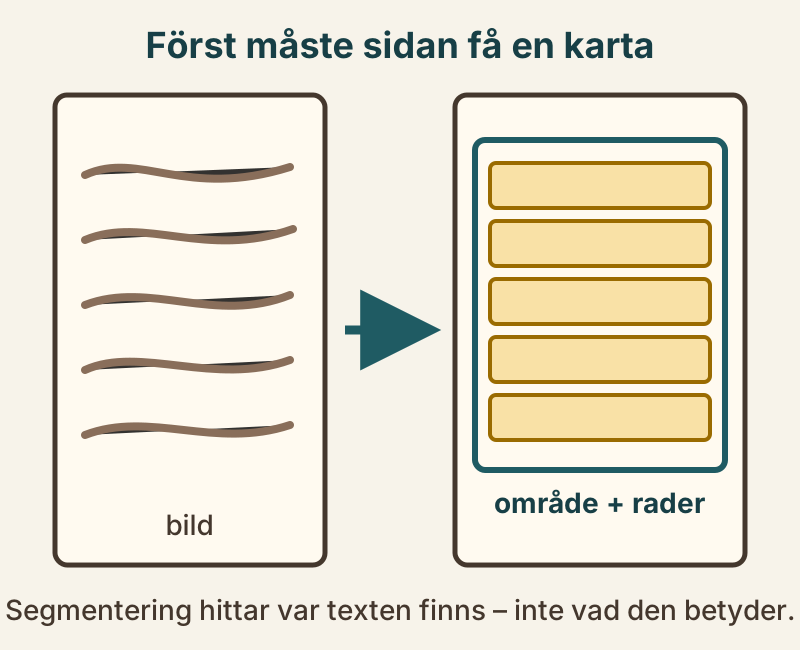
Den pedagogiska figuren visar principen: sidan delas först upp i radbilder. Den återger inte automatiska markeringar på titelbildens dagbokssida.
Den skillnaden hjälper också vid kontroll. Om två rader råkar slås ihop kan man förbättra segmenteringen utan att behöva träna om språkmodellen. Om raden är rätt beskuren men texten ändå blir fel ligger problemet längre fram.
2. En rad blir ett förslag till text
När en rad är utklippt får textmodellen bilden som indata och producerar en följd av tecken. Riksarkivets modell Swedish Lion Libre är uttryckligen gjord för radbilder med historisk svensk handskrift från 1600- till 1900-tal. Modellkortet betonar samtidigt att den fungerar bäst på handskrift som liknar materialet den tränats på. [6]
Det är frestande att säga att modellen ”ser ett ord”. En försiktigare beskrivning är att den räknar fram en trolig teckenföljd utifrån mönster som den har lärt sig. Resultatet är en transkription, inte ett facit. Ovanliga namn, äldre stavning och en främmande skrivstil kan därför vara särskilt viktiga att kontrollera i originalet.
För att lära modellen behövs exempel där människor redan har kopplat rätt text till rätt radbild. Riksarkivet beskriver hur frivilliga har transkriberat material för nya HTR-modeller och rättat automatiskt tolkade polisrapporter. Riksantikvarieämbetet beskriver samma grundidé i Swedish Lion-projektet: medborgarforskare hjälper till att skapa träningsdata för AI:n. [7]
Människan försvinner alltså inte när modellen tas i bruk. Hennes arbete flyttar delvis bakåt i kedjan, till urval, transkription och kontroll av träningsmaterial. Ju tydligare den kopplingen dokumenteras, desto lättare blir det att förstå vad modellen kan – och vad den sannolikt missar.
3. Raderna måste tillbaka i ordning
Efter textigenkänningen ligger resultatet fortfarande som separata rader. HTRflows steg för läsordning sorterar dem till en sammanhängande följd; i det enkla exemplet används ordning uppifrån och ned. [8] På sidor med flera spalter, marginalanteckningar eller formulär blir den uppgiften mer krävande.
Sedan exporteras resultatet. HTRflow kan skriva vanlig text och ALTO XML, där texten kan behålla sin koppling till sidans områden och rader. [9] Det är den kopplingen som gör en transkription mer användbar än ett fristående textdokument.
I ett bra arbetsflöde kan man därför spara både vad modellen skrev och var på sidan den hittade raden. När någon senare upptäcker ett tveksamt namn behöver hela volymen inte läsas om från början: kontrollen kan ledas tillbaka till rätt utsnitt.
4. Texten blir sökbar – med en väg tillbaka
Nästa steg är att lägga den exporterade texten i ett sökindex. Tänk på indexet som bokens register, men skapat för varje maskinläst ord. En sökning behöver då inte öppna och tolka alla bilder på nytt; den letar i textlagret och visar de poster där ordet förekommer.
Riksarkivets söktjänst låter användaren avgränsa till transkriberat material. I bildvisningen finns sök- och textpaneler, och myndighetens frågor och svar beskriver hur ett träffat ord markeras i transkriptionen bredvid den skannade sidan. [10]
Sökträffen är en dörr, inte slutpunkten: ordet i textlagret ska leda tillbaka till den bevarade bilden.
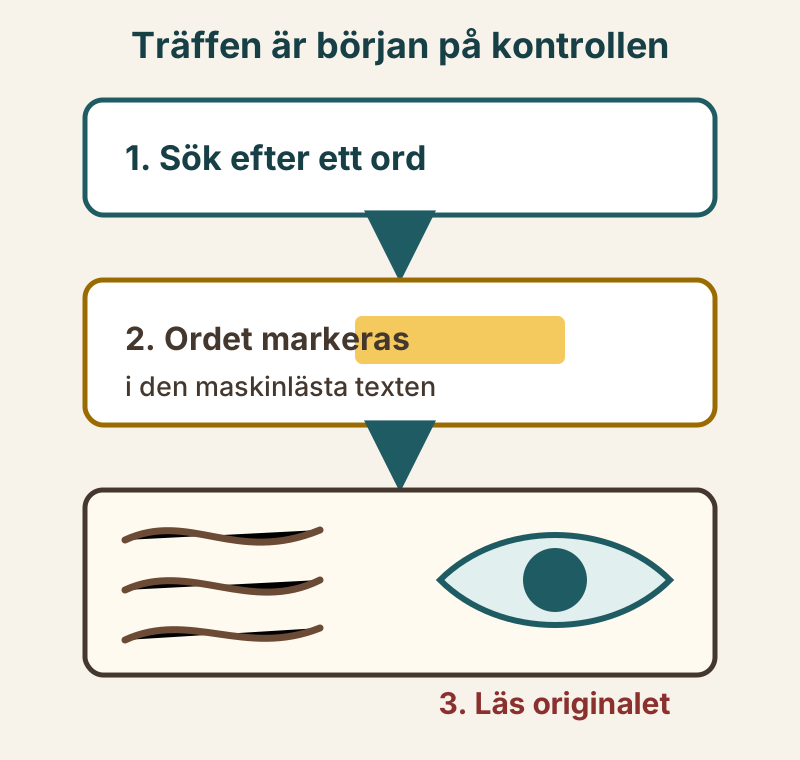
Här syns hela poängen med två lager. Texten ger räckvidd: forskaren kan pröva ett namn i stora mängder material. Bilden ger kontroll: bokstavsformer, överstrykningar och sammanhang kan granskas där uppgiften faktiskt skrevs.
Men en utebliven träff är svagare än den först verkar. Eftersom bara skannade och bearbetade sidor kan finnas i fulltextindexet betyder ”ingen träff” inte automatiskt ”inget historiskt belägg”. Det kan också betyda att rätt handling inte har skannats, att just sidan saknas i bearbetningen eller att modellen skrev ordet på ett annat sätt. [11]
Hur fel mäts – och varför måttet inte räcker
Riksarkivet skriver uttryckligen att AI-genererade texter kan innehålla fel. I den nuvarande söktjänsten går det enligt myndighetens frågor och svar inte heller att skicka in rättningsförslag direkt. [12] Det gör länken till originalet extra viktig.
Ett vanligt tekniskt mått är CER, Character Error Rate. Det räknar tecken som har bytts ut, tagits bort eller lagts till jämfört med en mänskligt kontrollerad referenstext och delar summan med antalet tecken i referensen. Lägre CER är bättre. [13]
CER-figuren är ett räkneexempel. Den visar substitution, borttagning och tillägg – inte ett uppmätt resultat för ett särskilt arkiv.
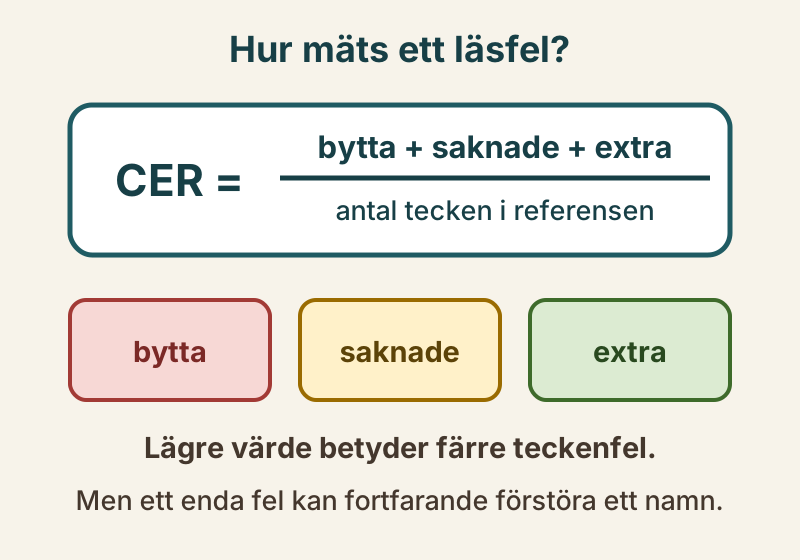
Måttet är användbart för att jämföra modeller, men det säger inte ensamt hur bra en sökning fungerar. Ett fel i ett vanligt ord kan vara mindre avgörande än ett enda fel i det släktnamn som forskaren söker. Modellkortet för Swedish Lion Libre visar dessutom att resultatet varierar tydligt mellan olika testmaterial och skrivstilar. [14]
Det talar för två sorters kontroll. Utvecklaren behöver mäta fel på representativa testdata. Användaren behöver se den konkreta raden. Ett genomsnitt kan beskriva systemet; bara originalbilden kan avgöra vad som står på den plats som är viktig just nu.
En söktjänst, inte en sanningsmaskin
När kedjan fungerar väl förändras forskarens startpunkt. I stället för att bläddra sida för sida kan hon börja med ett namn, en ort eller en fras och snabbt nå lovande dokument. Men arbetet slutar inte vid träffen. Den maskinella texten är en vägvisare som måste kunna granskas mot källan.
Det är därför den bästa bilden av arkivens AI inte är en robot som läser perfekt. Det är ett genomskinligt arbetsbord med flera verktyg: ett som hittar rader, ett som föreslår tecken, ett som ordnar texten, ett som bygger index och en tydlig länk tillbaka till papperet. Varje steg kan förbättras. Varje steg kan också kontrolleras.
Källor
- Riksarkivet: AI-transkriberade arkiv
- Riksarkivet: Frågor och svar om söktjänsten
- Riksarkivet: HTR – maskinell texttolkning av handskrivna arkivmaterial
- HTRflow: Quickstart
- HTRflow: Pipelines
- Riksarkivet: Swedish Lion Libre – modellkort
- Riksantikvarieämbetet: Medborgarforskning och AI-teknik skapar ett Swedish Lion